新卒 SRE として半年働いた感想
はじめに
今年の 7 月から(時期が中途半端な理由は省略)新卒 SRE として働いています。 新卒で SRE になる人はまだそこまで多くないと思うので、誰かの役に立つかも(?)という気持ちで感想を書いてみようと思います。
前提
所属する組織・チームにより色々と異なる部分が多いと思うので、補足しておきます。
- メガベンチャーで SRE の横断的な部署に所属している
SRE を目指したきっかけ
僕の場合はそもそも絶対に SRE になろうとも思っていませんでした。何なら今も SRE であるという認識は薄いです。 ただ、就活の振り返りも兼ねてなぜ SRE になろうと考えていたのかを改めて整理してみます。
- 何となくカッコいい気がした
- 非機能要件に注力する面白さ
- 扱う技術スタックの幅広さ
1つ目の理由は一部の人には怒られてしまうかもしれませんが、当時流行っていて何となくカッコ良さそうだったからというものです。 僕が就活をしていたのは 2022 年頃であり、個人的な体感としては SRE が盛り上がりを見せていた時期だったように感じます。実際にはもっと早くから盛り上がっていたのは間違いないのですが、就活生のようなリアルな開発現場に精通していない層にも SRE という単語が徐々に広がり始めたのはこの前後の時期だったような気がします。例えば Topotal さんの創業は 2020 年で、自分は SRE を軸に事業を展開する企業があることに少し驚いたことを覚えていますし、実際に短期インターン先が Topotal さんと一緒に仕事をしており、その業務内容を近くで見ていて漠然とした憧れのようなものもあった気がします。

2つ目の理由は非機能要件に注力する面白さです。SRE とはその名の通りシステムの信頼性に責任を負う立場であり、非機能要件に対して SLI / SLO を策定してパフォーマンスを改善していく、というイメージがありました。施策開発(〇〇の機能を開発するイメージ)よりも技術的な課題を解決するような仕事をしたかったため、SRE の仕事は自分の興味とマッチするのではないかと考えていました。
3つ目の理由は扱う技術スタックの幅広さです。SRE は仕事の性質上インフラ・アプリケーションの両方に関わる機会が特に多いと思います。僕は CS 的なセキュリティ・ネットワーク・データベースなどのインフラ寄りの技術に特に興味がありつつ、実装も割と好きなタイプだったため、この点は特に魅力的でした。過去記事を見て頂ければ分かるように、低レイヤ技術も好きだったので、この辺りの知識・興味が活かせるのでは?という期待も少しありました。
どんな働き方をしているの?
僕の所属するチームは横断組織ではあるものの全社的なものではなく、いくつかの子会社を束ねるグループをスコープとする組織だったため、そこに含まれる子会社のうちの一つに入って仕事をしています。お給料の支払いの都合などからいずれかの子会社に籍を置き、大部分はその子会社で仕事をしつつ、たまに両方の会社に関わる仕事しています。いわゆる Embedded SRE 的な働き方が一番近いと思います。ただ、関わる子会社は全て同じビルの同じ階に集まっているため、距離感としてはどこも結構近く、また僕のチームは Embedded SRE という単語を意識的に使っている訳でもないです。
横断的な組織なのだから横断的なプロジェクトをやるのでは?と思う方もいるかもしれませんが、扱うプロダクトや技術スタック、チームの雰囲気も異なる会社間で統一的に何かをやるというのは機会としてはそこまで多くなく、それぞれの会社に固有の問題をその時々で解決できるように頑張ることが多いです。また、横断的な仕事はそれだけ関わる人も多いので、僕の所属する組織だと比較的経験の豊富なシニアエンジニアが担当することが多いように感じます。
僕のチームだと規模の大きいプロジェクトは複数人の SRE が主導しますが、ジュニアの僕がやるような小〜中規模のプロジェクトは基本的に僕が一人で行い、進捗管理などのマネジメント的な部分は同じ SRE であるメンターの方にやってもらっているような状態です。マネジメント部分に関してはメンバーの大半がミドル〜シニア層ということもあり体系化は全くされておらず、メンターの方次第です。メンターに誰がつくかという点もプロジェクト次第です。
半年の間にどんなことをやったの?
あまり詳しくは書けないのですが、フロントエンドのコンピューティング基盤の移行とセキュリティ関連のプロジェクトをそれぞれ 3 ヶ月ずつ取り組みました。 前者は公開記事になっているため最悪 OSINT されても良いため少し詳し目に書き、後者は結構センシティブなので、ガッツリぼかして書きます。
フロントエンドのコンピューティング基盤の移行は Cloud Run で動かしている Next.js のアプリケーションを GKE に移行するプロジェクトでした。このプロジェクトで入った会社は複数のプロダクトを一つの GKE で動かすプラットフォーム戦略を採用しており、歴史的な経緯から Cloud Run で動いているフロントエンドのアプリケーションを他のアプリケーションと同じように GKE に移動させることが僕の仕事でした。
せっかくなのでこの仕事をどう進めたのかという話をしたいのですが、基本的にはほぼ全ての裁量が僕に与えられている形で仕事を進めていました。具体的には、このプロジェクトの背景・やる価値の(再)整理、ゴールの(再)整理、やり方(スケジュール・タスクの分割粒度・レビュープロセス)、コミュニケーション(SRE だけでなくフロントエンド・バックエンド含め)も含めほぼ全て僕主導で考えて、メンターの方はそれに対して基本的にはOKを出しつつ、部分的に修正が必要そうだったら修正する、というスタンスです。僕の場合は、以下の流れにしました。
- まずは現時点(開始当初時点)で大まかな設計をFIXさせる
- 必要な技術スタックを学びながら設計の検証をする
- 実際にやる
技術スタック的にはふんわりと知ってること 6 割、全く知らないこと 4 割くらいだった気がします。具体的にはパブリッククラウドの基礎、Kubernetes の基礎、フロントエンドの基礎(特に React / Next.js の基礎知識)あたりは知っていることが多く、逆に Terraform や CloudFormation などの IaC や ArgoCD / Helm などの Kubernetes の周辺技術などはほとんど知らない状態でした。設計に関しては今ある知識でできそうだったため早めに終わらせ、技術的なインプットと検証に2週間程度、実際に移行作業を残りの期間で取り組んだ形になります。
セキュリティ関連のプロジェクトでは別の会社に異動し、既にいくつか予定されていたセキュリティ関連プロジェクトの一つを担当しました。細かいことは言えませんが、認証認可周りの改善でした。 この会社は AWS をガッツリ使ったインフラを組んでおり、Terraform / AWS 周りに関しては結構自信がつくくらいには学びが多かったです。 あと、元々大学院ではセキュリティ系の研究をしていたため、その知見が活かせたのも個人的には嬉しかったです。
後悔していること・困ったことはある?
過去は変えられないのでどうしようもありませんが、早期入社という選択は少し危険だなと思いました。基本的に研修無しでプロジェクトに参加するので技術的なキャッチアップが大変なことと、同期がいないため相談などが気軽にできない点が主な理由です。他に関しては特に困ったことなどはありませんでしたが、正直なところ、関わる会社・チームとは本当に雰囲気から全然違うため、合う合わないは明確にあるなと感じています。僕の今後のキャリア的な観点で言えば、横断的な部署には所属せずに、自分と合う場所(子会社・チームなど)に行くと思います。横断的な部署には後述するような良い点もたくさんありますが、新卒では関わる人間が多い・短〜中期的に入れ替わることはマイナスに働きがちかなと思います。あとは、まだまだ新卒 SRE は少ないので、同じ目線で相談できる人が少ないのもたまに困ります。
あとは単純に技術スタックとして扱う幅が広いですし、僕が所属する組織含め基本的に裁量が広い現場も多いため、シンプルに大変に感じる人が多いんじゃないでしょうか。何かトップダウンに仕事が降りてくるというよりは、現場との対話や自分の目で確かめた状態からより良い状態を考え、提案をして、実行までやり切るというやり方が多い気がしています。僕の場合は今の所フワッと課題感がある・あるいは明確に課題感があるものを与えられて、それを自分も納得した上で取り組んでいるような状態です(少し違う言い方をすれば、やらなくてもいいと思いますと言っても良いし、やり方をガラッと変えても良い)。これは僕としては嬉しい部分が勝っていますが、もう少し幅を狭めてあげたほうが新卒には優しいかなと思ったりもします。基本的にどのプロジェクトも周りのエンジニア(時にはビジも)の協力ありきで進める必要があるため、なぜやる必要があるのかを説明できる必要がありますし、問題なくやり切るためにはソフト・ハード共に結構なものが求められると感じています(まあこれは僕が実力不足なだけ、というのももちろんあります)。結局はどの仕事も大変なので、この点に関しては自分も正直よく分かりません。
逆に良かったことは?
色々な人と関わりながら広い範囲に影響する仕事をすること・様々な技術スタックを扱えることかなと思います。プロジェクトのボトルネックの大半はコミュニケーション・調整の部分だったので、趣味や研究でやるのと仕事でやるのにはこんなに違いがあるということを身をもって知ることができました。また、SRE を目指した理由にも書いた目論見通り、非常に多くの技術を扱うことができました。これは明確に SRE になってよかった点だと思っています。
結論(SRE になって良かったと思ってる?)
なってよかったと思っています。上述した幅広い技術を扱えている点が主な理由です。困ったことに書いたことの大半は、僕個人の意見としてはむしろありがたいハードルとして受け入れて楽しくやれています。ここを楽しめるかどうかが割と大事なんじゃないかなと思います。
まとめ
2024 年の振り返りはこれでヨシとしてください!
NAIST を修了してしまった
はじめに
ゴリゴリの文系から NAIST の修士(情報領域)に入ってどうだったのよ?という話です。ハッピーエンドです。 文脈というやつは無く、ただ思いついたことを書きました。
研究は楽しかった
研究は本当に楽しかったです。出した業績は国内研究会 1 本、査読つき国際会議 1 本なので、大したものではありませんが、どちらもそれなりに評価して頂くことができました。研究会は奨励講演への招待と推薦論文の候補に、国際会議は Best Papers に選ばれました。研究的にも学部のバックグラウンドは本当に一ミリも関係なく、Intel CPU に積まれたセキュリティ機構を使ってデータベースのプロセスを保護するという割とシステム寄りな研究で、実装もデータベースを一から作るという重めのものでしたが、ちゃんと研究として形にすることはできたと思います。意外とやってやれないことも無いんだなと思います。文系から NAIST に来る人は自然言語処理に行く人が多いですが、ゴリゴリに実装系の研究をやりたい人も特に心配はしなくても良いと思います。僕は入学時この点が結構不安だった記憶があるので、もし学部は文系だけど OS 自作とかが好きな変わった人がいたら、全然なんとかなるよということを伝えたいです。また、うちの研究室は研究を中心に頑張る人もいれば、CTF や機械学習コンペなどを中心に頑張る人もいて、必ずしも研究を頑張り続けないといけないという圧が存在しないのも良かったです。もちろん最終的に修士論文を書く必要はありますが、好きなことを自由にやれたのは、本当に研究室に恵まれたなと思います。まあ、僕は研究(というか研究の過程で作るデータベース)にハマってた側でしたが。
秋入学はしない方が良い
僕の考える秋入学のデメリットは以下の通りです。
- 寮に入れない
- (厳密な意味での)日本人同期が少ない
- 就活が面倒
まずは 1 を説明します。大前提、NAIST の寮は希望した学生全員が入れる訳ではなく、それ故に優先度が存在します。優先度の高い順から 博士、日本人以外の修士(春・秋)、日本人の修士(春)、在学生 という優先度になっています。日本人の春入学組のうち成績の良い人は最初から入寮でき、そうでない人は半年から一年待って在学生として入学することになります(大半の人は寮以外に一度住んだら引っ越さないとは思いますが)。それぞれの割合は年度により変動しますが、基本的に博士と留学生はほぼ確実に入寮できます。博士は単に母数が少なく優遇対象ですし、留学生も手続きの煩雑さなどの理由から原則優先的に入寮できます。しかしここで一つの問題があります。そうです。お気づきの通り、この中に 日本人の修士(秋) は存在しません。なぜなら、そもそも 秋入学の日本人は原則寮に入ることが出来ず、半年待って在学生として応募する必要がある からです。直近の数年は在学生で希望した学生は全員入寮できているようです(学生課に聞きました)が、可能性として入寮できないかもしれない、そもそも半年待ってから引っ越すという面倒さを受け入れなければならない、という点は事前に把握しておく必要があると思います。個人的には、安い UR に住む、家具付き物件に住む、などの工夫をすると良いと思います。自分は家具付きのレオパレスに住んでいました。
2 は自明ですが、秋に入学するような日本人というのは殆どいません。これは単位取得の計画を相談したり、一緒に授業を受けたりする人が少ないことを意味します。入る前から分かるという点からも 1 ほど大きなデメリットだと思いませんが、ちょこちょこ面倒です。ただ、春入学組も割と単位の取り方は人それぞれで、秋にも全然授業を取っている人もいます。そのため、そこまで困るということも無いと思います。
3 は人によっては致命的かもしれません。そもそも秋入学してる時点で普通に春入学組と同じように就活できないことは分かると思いますが、想像以上に面倒です。まず、秋入学からそのまま就職しようとしている人は、(1) 修了後間を空けずに就職する(つまり10月入社)か、(2) 半年待って入社するか、(3) 半年早く卒業するか、を選ぶ必要があります。(3) は研究の進捗や研究室の方針によるため、就活時点でこの選択肢を取れる人は殆どいないと思います。つまり、実質的には半年待つかどうかを決める必要があります。先に結論から書くと、一般的には半年待つ方(つまり (2)) を選ぶことになります。これは 10 月に新卒を入社させられるような柔軟性を持った企業が少ないためです。普通の企業なら最低でも最初の数週間から 3 ヶ月程度は研修期間を設けているため、これはある意味仕方のないことだと言えます。しかし、これの何が嫌かというと、就活の時期と研究が忙しい時期が被ってしまうのです。NAIST は大体卒業月の 3 ヶ月前くらいには修論を書き始め、1 〜 2 ヶ月前に修論の提出と審査があります。3 月卒業の場合、12月頃には修論を書き始め、1 月末に修論を提出、2 月頭から中旬にかけて修論審査を行うのが一般的です。2 回目の中間発表(内部ではコロキアムと呼ばれているもの)が 6 ヶ月前の 9 月にあり、この 9 月から翌年 2 月までが研究を最も頑張らないといけない時期です。そして、このスケジュールを秋入学に置き換えると、3 月から 8 月が最も研究が忙しい時期となります。 お分かりでしょうか ...? この期間の前半、つまり 3 月から 5 月というのは秋入学組の就活の本選考の時期ともろに被っている のです。昨今では就活の早期化が進んでいるため一概には言えません(実際に自分も早期化の恩恵を受けた側です)が、秋入学をして、新卒として社会に出ようと考えている人はこの点に注意する必要があると思います。個人的にはこの点だけを考慮しても、半年待ってから春入学した方が良いと思っています。
早期卒業という選択肢もある
上記の就職の選択肢の (3) で少し触れましたが、NAIST は 3 ヶ月ごとに修了できるタイミングがあり、早期修了も可能です。僕は 9 月卒業のところを 3 ヶ月早めて 6 月卒業にしました。これは本当に珍しいケースなのであまり誰かの参考になることは無いと思いますが、僕は以下の条件が揃ったのでこのような選択肢を取りました。
- お金が無い(これに尽きる)
- 研究的には割と片付いていた
- 7 月という意味の分からない時期の入社を会社が了承してくれた
諸々調整してくださった先生方と会社の方々には頭が上がりませんね。本当に。
のどかな日々
NAIST での生活を振り返ると、本当に最高に自由で、のどかな日々だったと思います。人が少ないのに面積は大きく自然は多いです。東京のような人の多い空間が苦手だった僕にとっては、生活環境としてこの上なく合っていたと言えると思います。また、僕の研究室はコアタイムもありませんでした。好きな時に起きて好きな時に寝て、たまに(春入学の)同期の車に乗せてもらって寿司食って銭湯に入る。スマブラをやる。桃鉄をやる。後輩が作ってくれた格安(300円)の美味い飯を食う。ババ抜きをする。たまにお酒を飲む。みたいな感じです。人生の幸福ってやつはこういうものを指すのであって、僕はこれからどれだけ働いて大金を得てもこの生活は得られないと思うと、とても寂しいです(博士という選択肢はあえて無視します)。
最後に
NAIST に入って後悔することはあまり無いと思うから、悩んでいるなら入った方が良い。 色々とレアなケースだと思うので、自分がレアなケース側で悩んでいる人がいたら @oshiborii に DM くれたら多少相談にのったりはできます。受けた恩を誰かに還元しないとね。
「プログラマーのための CPU 入門 ― CPUは如何にしてソフトウェアを高速に実行するか」を読んだ
年明けの暇な時間を利用して読んでみました。
技術書としての感想
良かった点
- とにかく文章が分かりやすい
- 色々な用語の使い方に違和感がない
言葉にすると簡単ですが、本当に分かりやすかったです.
- 具体例が豊富
- 図が豊富
- コード例が豊富
- 実験例が豊富
まず、「〇〇 な場合に命令の処理が詰まって遅くなります」といった説明の後に、「では、具体的にこういったケースを考えてみましょう」という具体例を持ってくる展開が多く、とても親切だと感じました.また、このような具体例の説明のときにほぼ必ず図が用いられています.特に全体を通して頻繁に出てくる命令流の図は非常に分かりやすかったです.また、コード例とそれを用いた実験も豊富でした.具体的には、キャシュの章では実際にキャッシュミスを意図的に起こすコード・キャッシュヒットを意図的に起こすコードをそれぞれ実行してどれくらい速くなったか、などを確認できます.実際に理解した CPU の機構により速度が変わることを体感できたことで、理解度が深まった気がします.
- 構成に一貫性がある
この辺りも個人的にはかなり良かったです.特に各章は、
- CPU における高速化のための仕組み
- その仕組みがうまく機能しないケース・むしろ速度に悪影響を与えるケース
- ハードウェア・ソフトウェアによる緩和策
- まとめ
という構成でほぼ一貫しており、非常に読みやすかったです.
- 難易度が丁度良い
- より専門的な書籍や論文を読む足がかりになる
難易度もかなり丁度良く、普段 CPU を意識しない Web 寄りのソフトウェアエンジニア 〜 低レイヤ寄りのソフトウェアエンジニアあたりまでの人は読むとかなり学びがあるのではないでしょうか?自作 OS をしている人は 6 章 〜 8 章あたりの内容(仮想記憶、I/O、システムコール、例外、割り込み)は既に知っている内容も多いと思いますが、これらの仕組みを CPU の処理速度への影響という観点からまとめあげているため、依然として多くの学びがあると思います.例えば「TLB ミスと割り込みや例外による CPU の速度低下ってどっちの方が深刻なんだろう?」とか「パイプライン化などの高速化の機構により得られる恩恵と無駄な I/O を減らすことにより得られる恩恵ってどっちが大きいんだろう?」などの疑問に対する自分なりの答えが見つかるようなイメージです.自作 OS などは基本的には速度面を気にして設計・実装まですることはないと思うので、このような観点から知っている内容を復習できた点も個人的には嬉しかったです.
せっかく色々と学んだので、ここで得た知識で論文が読めるのか、を試してみました(参考).結果としては、かなりハードルの低い内容ではあったものの、今までの自分ではまず理解できなかったであろう内容を理解できました.このことから、より専門的な内容を知るために必要な内容が無駄なく詰め込まれていたのだな、と非常に感心しました.
悪かった点
個人的には無い
注意点
ソフトウェアを高速化するための具体的な技法みたいな部分にはあまり期待しない方が良いかもしれない。当たり前ですが、CPU 側の高速化技術に焦点を当てた書籍だからです。書籍内で紹介されている CPU レベルでの高速化技法は、ソフトウェア実装側からは操作できなかったり、意図的に使えたとしても高速化を達成するのが相当に難しかったりするからです。ただ、各章には「ソフトウェアによる緩和」という節が設けられており、一応こんなこともできるよ、というのは書かれています。
総評
めっちゃ良かった
論文メモ:Software Grand Exposure: SGX Cache Attacks Are Practical
はじめに
aos さんの資料(攻撃編 ①)と「プログラマーのための CPU 入門」の 5 章(キャッシュメモリ)を読んだので、試しにどれくらいキャッシュ関連の論文が読めるのか試してみた.読んだ論文は SGX に対するキャッシュを用いた攻撃を行うものであり、aos さんの資料でも簡単に触れられているものです.
前提知識
キャッシュのアーキテクチャ
論文の 2.2 節を読むか、プログラマーのための CPU 入門の 5.5 節を読みましょう.おそらく後者を呼んでから前者を読むと一番理解できます.僕も 5 章だけを読んだ上で論文を読んでいますが、
- キャッシュヒット / ミス
- キャッシュライン
- L1 / L2 / L3 キャッシュ
- full / set associative
- way
あたりの単語が理解できるだけで基本的には理解できる内容だと思います.雑に選んだ論文にしてはあまりにも丁度良い論文で運が良いですね.
Performance Monitoring Counters
論文の説明をそのまま DeepL に突っ込んだものを貼ります.
パフォーマンス・モニタリング・カウンタ(PMC)は、ハードウェア・イベントを記録するためのCPUの機能である。PMCの主な目的は、ソフトウェア開発者がプログラムを最適化するために、プログラムがハードウェアに与える影響を把握できるようにすることである。CPUには一連のPMCがあり、例えば、実行されたサイクル、異なるキャッシュのキャッシュヒットやキャッシュミス、予測ミスの分岐など、さまざまなイベントを監視するように設定できる。PMCは、監視するイベントと動作モードを選択することで構成される。これはモデル固有レジスタ(MSR)への書き込みによって行われ、特権ソフトウェアによってのみ実行可能です。PMCはRDPMC命令(リード・パフォーマンス・モニタリング・カウンタ)を介して読み出され、非特権モードで使用できるように設定できる。PMC によって記録されたハードウェアイベントは、サイドチャネルとして悪用される可能性 があります。そのため、SGX エンクレーブは、「Anti Side-channel Interference」(ASCI)[26]と呼ばれる機能を有効にすることで、エントリー時に PMC を無効にすることができます。これにより、固定サイクル・カウンターを除く、すべてのスレッド固有のパフォーマンス監視が抑制されます。そのため、エンクレーブによってトリガされるハードウェア・イベントは、PMC機能によって監視することができません。例えば、エンクレーブによってロードされたメモリのキャッシュミスは PMC に記録されません。
DeepL.com(無料版)で翻訳しました.
Prime+Probe 型の攻撃
aos さんの資料を読むか、論文の 4.1 節を読みましょう.適当(雑という意味)に説明するなら、
- キャッシュ (の特定の範囲)を埋め尽くす (prime)
- victim の攻撃対象の関数が実行される
- キャッシュにアクセスする (probe)
という 3 ステップで行う攻撃です.set associative なキャッシュではアドレスの一部(下位 1 バイトなど)がキャッシュライン上のインデックスになっており、これによりアクセス先のアドレスの値がキャッシュに載っているか高速に検索ができます.しかし、この方式だとインデックスが同じアドレスの値を 1 つしか格納できないため、インデックスが被ると過去にキャッシュに載った値が evict されることになります(そもそもキャッシュサイズ以上のデータを載せたら普通に溢れて evict されますがこれはまた別の話な気がする).これを利用すると、攻撃者が特定のアドレス範囲がどのキャッシュラインに載るかを知っているとき、そこを事前に埋め尽くした上で (これが 1) 、2 で victim の関数を実行し、3 でキャッシュにアクセスすることで、evict されたアドレスへのアクセスだけが遅くなることを確認できます.説明が下手すぎるので、やはり詳細は他の資料に頼みます ... .論文中の図が普通に分かりやすかったので引用しておきます.
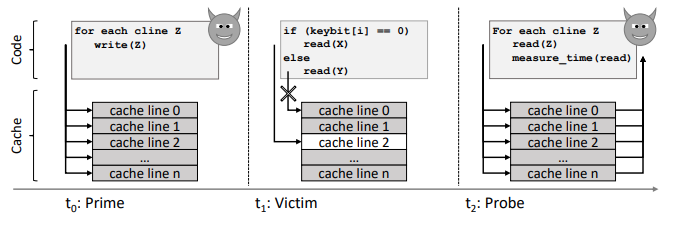
この Prime+Probe 型の攻撃はキャッシュ汚染(cache pollution) に悩まされがちらしいのですが、SGX の脅威モデルである OS が侵害された状況を考慮すると、色々とキャッシュ汚染を引き起こさないための対策ができるから、依然として Prime+Probe 型の攻撃は SGX に有効だぜ、という趣旨の論文です.
状況設定
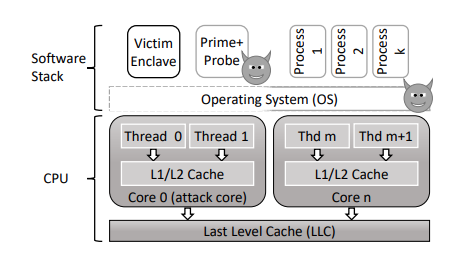
攻撃手法に入る前に、簡単に状況設定を説明します.この論文では攻撃者のプロセスと victim プロセスは別のプロセスであり、同じコアの別スレッド (hyper-threading 使う前提)で動きます.つまり、攻撃者のスレッドと victim のスレッドは並列に実行されます(以下の図を参照).hyper-threading ではキャッシュが共有されます.
攻撃手法:キャッシュ汚染に対する対策
基本的には Prime+Probe 型の攻撃なのですが、キャッシュ汚染を防ぐために色々と工夫をしています.キャッシュ汚染は、Prime+Probe コードと victim の攻撃対象コード以外の様々なコードがキャッシュを利用することです.キャッシュ汚染が起きると、victim によるキャッシュの evict を特定しずらくなります.この論文の貢献は SGX が想定するような脅威モデルにおいて、従来の Prime+Probe 型の攻撃を行いやすくするめに、様々なノイズ軽減(noise reduction)のテクニックを提案している点だと思います.以降では一部を紹介します.
Isolated attack core
Prime+Probe 型の攻撃はキャッシュ eviction を観察することにより機密データを特定するものです.しかし、キャッシュというのは複数のコアにより共有されているため、一般的な状況では攻撃者は evict が victim により発生させられたのか、他のコアで実行されている別のプログラムにより実行されたのかを判別できません.しかし、この研究(というか SGX の脅威モデル)では攻撃者が OS を完全に掌握しているため、特定のプログラムを特定のコアでのみ実行するように細工できます.具体的には、攻撃者が用意する Prime+Probe コードと victim のコードのみが実行されるコア(論文では attacker core と呼んでいるため以降はそれに従います)を用意します.これにより evict が発生した場合にはそれが victim からのアクセスにより引き起こされたことが確定します.
Self-pollution
攻撃者は特定のアドレスに紐づくキャッシュラインを観察しますが、このキャッシュラインが Prime+Probe コードと victim の攻撃対象のコード以外からもアクセスされるとキャッシュが汚染されやすくなってしまいます.この研究ではデータキャッシュと命令キャッシュが分離されている L1 キャッシュを利用することでキャッシュ汚染を軽減しています.攻撃者が関心があるのはデータキャッシュであるため、L1 キャッシュを使うだけで少なくとも他の命令が観察対象のキャッシュラインにキャッシュされることによる汚染は防げます.依然として victim の他の部分で発生したデータアクセスによりデータキャッシュが汚染される可能性はあります.
Uninterrupted execution
割り込み(interrupt) も攻撃者にとっては都合が悪いです.SGX の AEX に限らず割り込みが発生すると対応する割り込みハンドラが呼ばれますが、これらのプログラムも通常のプログラムと同様にキャッシュを利用するため、やはりキャッシュ汚染が起きます.論文ではこれを防ぐために攻撃者のプログラム及び victim プログラムを可能な限り割り込みを発生せずに実行させます. 対策としてはシンプルで、割り込みが発生するとその割り込みを処理するコアが割り当てられますが、そのコアに attacker core が割り当てられないように割り込みコントローラを設定します.唯一の例外は各コアが持つタイマーからの割り込みらしいですが、これはタイマーの周波数を下げることで、10 ms はタイマー割り込みが入らないようにして影響を軽減していて、この時間(10 ms) は割と十分に長いらしいです.
Monitoring cache evictions
従来の研究はキャッシュの evict をメモリアクセスのレイテンシにより判断していましたが、これはかなり難しい作業らしいです.例えば、L1 キャッシュへのアクセスが 4 サイクルで、L2 キャッシュへのアクセスが 12 サイクルの場合、その差は非常に小さいです.そのため、従来の研究は L3 キャッシュを観測することで L3 キャッシュへのアクセスと DRAM へのアクセス速度の差が分かりやすい状況を利用していました.しかし、この研究は L1 キャッシュを利用しているため、そうもいきません.そこで、この研究では上述の PMC を利用することで確実にキャッシュミスのイベントを取得できます.ASCI による対策があるじゃないかと思うかもしれませんが、あくまで PMC により取得するのは攻撃者が用意した Prime+Probe コードのイベントなので、ASCI は意味を成しません.
既存研究との違い
基本的には Prime+Probe 型のキャッシュを対象としたサイドチャネル攻撃です.論文の Parallel work on SGX cache attacks で直接言及されているのは Gotzfried et al , Schwarz et al, CacheZoom の 3 つでした. Gotzfried の研究は攻撃手法自体はこの研究と似ているのですが、あまり現実的ではない仮定を置いていたようです.具体的には、(1) 攻撃者と victim のコードは同じプロセス内の別スレッドとして動作する (2) 攻撃者と victim のコードは共有バッファを利用する(このバッファを介して攻撃者は復号したいデータを victim に渡せる) (3) 攻撃者と victim は協調して動いていて、prime と probe を完璧なタイミングで一度で行える、というものです.個人的には (2) は Switchless Call があるので割と現実的な気もしますが、(1) と (3) はあまり現実的ではない気がします.ただ、SGX の脅威モデル的には (1) は一応整合している(untrusted なメモリのコードは同一プロセスでも信頼できない)気もしますし、(3) も AES の最終ラウンドの終了が関数の終了であれば、あとは何回も攻撃を行えるのであればもしかしたらそういった状況もあり得るのか ... ?という気もします.このあたりは専門家でないと分からないと思いますが. Schwarz の研究はそもそも対象が L3 キャッシュらしいです.CacheZoom は詳しくは分かりませんが、割り込みによって victim プロセスを頻繁に中断させるらしく、これは既存のサイドチャネル攻撃の検知技術に引っかかりやすいという問題があるらしいです.
上記を総括すると
- L1 キャッシュを対象としてる
- 割と現実的な(?)仮定の元で攻撃が成立する
- 既存の割り込みを用いた攻撃よりも検知されにくい
などの違いがあるということみたいです.
おわりに
割と理解できるものだなと思いました.おもしろかった.暇だったら評価などを追記するかもしれないです.
論文紹介:Building Enclave-Native Storage Engines for Practical Encrypted Databases (1)
- はじめに
- Trusted Execution Environment (TEE) とは何か
- この研究のモチベーションは?
- DBMS with SGX は何が辛いのか?
- ストレージエンジンの構造
- 設計上の選択肢とトレードオフ
- 設計ポイント
- おわりに
はじめに
興味のある分野の論文をたまに紹介するやつを定期的にできたらなあと思ってます.全く続かない気もしますが、とりあえずは第一段です.僕自身読み飛ばしたり理解できていない部分があるため、間違いがある場合は指摘してください.書いている途中であまりにも長くなりそうだったため、記事を分割することにしました.本稿では前提知識、この研究のモチベーション、この研究の着眼点あたりを説明します.以降の記事では提案手法を説明します(もし続けば ... ).
論文の リンク
Trusted Execution Environment (TEE) とは何か
TEE はハードウェアレベルで安全な隔離実行環境です.ハードウェアレベル、というのは root of trust がハードウェアであることを意味しており、 TEE は CPU が root of trust になります.昨今では様々なデータを扱うプログラム(プロセス)が存在しますが、それらを強力な権限を持つ攻撃者から守る手段が乏しく、より改竄されにくいハードウェアがプロセスに強力な保護を提供しようというものです.技術的には、MMU / TLB などのアドレス変換周りの技術を用いた特別なアドレス空間の作成 とメモリ暗号化技術により、通常のプロセスや特権的なソフトウェア(e.g. OS、ハイパーバイザー) からの攻撃にも耐性を持つ環境でプロセスを実行できます.Intel Software Guard Extension (SGX) は Intel 製の CPU における TEE であり、ring 3 のプロセスを安全に実行できるものです.SGX の概要は aos さんの記事 が詳しいです.TEE はチップベンダごとに Arm TrustZone や RISC-V KeyStone 、AMD SEV-SNP 等が存在しますが、今回は割愛します.TEEはいわゆる秘密計算技術のうちの一つですが、完全準同型暗号や秘密分散を用いた手法よりもオーバーヘッドが小さく、より実用的であるという特徴があります.近年では、機密データを扱うソフトウェアとして誰もが納得するであろう Database Management System (DBMS) を TEE を用いて保護する研究が増えています.従来のリレーショナルな RDBMS をはじめ、KVS を TEE で保護する研究もあります.今回紹介する論文は古典的な RDBMS におけるストレージエンジン(明確な定義はともかく、メモリ及びストレージ上のデータ操作を行う DBMS の心臓のようなもの) を TEE を用いて保護する研究になります.
この研究のモチベーションは?
以下、論文からの引用です.
Though some enclave-based encrypted databases emerge recently, there remains a large unexplored area in between about how confdentiality can be achieved in diferent ways and what infuences are implied by them.
enclave というのは TEE における安全なメモリ領域のことです.ここに書かれている通り、Enclage のモチベーションは Intel SGX を用いた encrypted database における設計上の選択肢を明らかにし、それらのトレードオフを分析する ことにあります.実際に論文内では様々な観点から複数の選択肢を示しており、それらのトレードオフを定性的(一部は定量的)に分析しています.そして、それらのトレードオフを考慮したときに最も実用的と考えられる "バランスの良い" ストレージエンジンを提案してみたよ、というのが基本的な内容になります.
DBMS with SGX は何が辛いのか?
モチベーションが理解できたところで、SGX と DBMS を組み合わせる上で主要な課題について説明します.後述のトレードオフを理解するためにはこの課題を理解しておく必要があります(どれも直感的なので安心してください).論文では以下の 3 点を SGX の課題としています.
- enclave サイズの制限
- enclave 内外の関数呼び出しコスト
- Trusted Computing Base (TCB) の最小化
1. enclave のサイズ制限
1 について、まずプロセスを安全に実行可能なメモリ領域である enclave のサイズは制限されています.古めの SGX なら 128 ~ 256 MiB 、Xeon の第三世代以降のスケーラブルプロセッサなら 512 GiB (1ソケットあたり) に制限されています.512 GiB 使える環境は非常に限定的であり、Azure の Confidential VM でもだいたいメモリ全体の 50% ~ 75% くらいが enclave に割り当てられています.具体的に必要な enclave サイズは扱うデータサイズに依存するので一旦議論しないとして、とにかくメモリ全体を使えるわけではない、という点が重要です.DBMS はストレージ上のファイルをメモリに展開しながら動作するため、このメモリサイズの制限は特に致命的です.最近のインメモリ技術なんかも考慮するとまあ辛そうなのは明らかです.
2. enclave 内外の関数呼び出しコスト

また、Intel SGX は 1 つのプロセス内で一部のコードのみを enclave 内で動かす、という上記のような保護モデルを提供しています(画像は ここ から引用).図の左側が通常のメモリ領域であり、右側が enclave です.通常のメモリ領域に配置されたコードは Intel SGX SDK が提供する Ocall / Ecall というラッパー関数を用いて Enclave 内外の関数呼び出しを行います.図における Call Trusted Func が enclave 内の関数を呼び出す Ecall であり、図には書かれていませんがその逆が Ocall です.Ecall はともかく、なぜ Ocall などという以下にも攻撃対象になりそうな機構があるのでしょうか?答えとしては、enclave 内でできないことがあまりにも多すぎるからです.上記で触れた aos さんの記事などにも書かれていますが、enclave 内ではシステムコールを利用できません.そのため、システムコールを必要とする処理(I/O など)は全て一旦 enclave 外に出て行う必要があります.例えば、printf を用いて Hello World したい場合、
- ocall_printf のような Ocall を定義する
- ocall_printf 内部で printf を行うコードを書く
- enclave 内から ocall_printf を呼び出す
みたいな流れが必要になります.気になる方は aos さんの実践編の記事を読んでみてください.詳細はともかく、この Ocall / Ecall の呼び出しのオーバーヘッドが非常に大きい、というのが 2 つ目の課題です.全てのデータを enclave 内に展開してしまえばこの問題も少しは緩和されるのですが、実際にはそれは無理で、一部のデータのみを enclave 内に置きます.enclave 外へのデータアクセスは Ocall / Ecall を必要とするので、じゃあ何をどこに置くべきなの?という問題が出てきます.また、既存の DBMS もストレージアクセスを最小化する方針で基本的には動いていますが、SGX を使う場合は普通のディスクアクセス + Ocall / Ecall のオーバーヘッドがあるため、I/O のコストは相対的に通常の DBMS よりも大きくなります.
3. TCB の最小化
最後に、TCB (参考:Wikipedia) の最小化です.TCB は適当に言えば「そのシステムにおいて安全であると信頼されるべき部分であり、ここが侵害されると全てが崩れるような大事な部分」です.Intel SGX などの TEE を用いる場合は enclave 内で実行するコードを指して TCB と言います.直感的に分かる通り、ここが大きければ大きいほど脆弱性を生みやすいです.逆にここが小さければ小さいほど、システム全体の安全性を担保しやすいです.大規模なシステムよりも小規模なシステムの方がセキュリティを担保しやすい、という当たり前の話です.
SGX の実用が難しいのは、上記の 3 つの課題が密接に関連しているからです.例えば、TCB を小さく enclave のメモリ使用量を抑えようとすると、必然的に enclave 外のコードが増えます.そうすると、(処理の内容にもよりますが)Ocall / Ecall の回数は増えます.イメージとしては、モノリシックとマイクロサービスのトレードオフに似ていて、マイクロサービスにすると通信コストが増えるのと同様に Ocall / Ecall が増える感じです.この論文のモチベーションはこのようなトレードオフ自体は明らかであるものの、じゃあ実際にどうするのが正解なの?という問いに答えることにあります.
ストレージエンジンの構造
以降の説明に備え、Enclage が想定する基本的なストレージエンジンの構造を説明します.Enclage は B+ tree ベースのインデックスとヒープファイルベースのデータストア(データのキャッシュ)を持つストレージエンジンを想定しています.後者はいわゆる Buffer Pool というやつです.ストレージエンジンはデータへのアクセスが発生すると、インデックスが貼られている場合はまずインデックスを探し、無ければ Buffer Pool にアクセスします.それでもなければストレージから Buffer Pool にデータを読み込みます.イメージは以下の画像のようになります.Buffer Pool について詳しく書かれた資料はあまり無い気がしますが、The internals of PostgreSQL は詳しめに書かれています.

設計上の選択肢とトレードオフ
論文の流れのままに説明したいと思います.まず、 B+ を素朴に enclave 外に配置した場合の利点と欠点について説明します.少しいきなりに感じるかもしれませんが、この例は後述のいくつかのトレードオフを論じる前のクッションとして非常に有用です.
最も簡単な暗号化 B+ tree の実装と問題点
以下の画像は論文から引用したもので、enclave 外 に配置可能かつ最も簡単な暗号化 B+ tree の実装です.この実装は探索処理においてキーの比較処理以外を全て enclave 外で実行できるため実装が非常に容易な一方で、以下のような問題があります.
- Ecall の頻発による性能低下
- 暗号化処理との相性の悪さ
- キーの順序関係・親子関係の漏洩
1 はキーの比較のたびに Ecall が呼ばれるからです.2 は暗号化において細かいデータを暗号化すると初期化コストが増えがち + メタデータのサイズが増加(所謂 ciphertext amplificaion)してしまうからです.この問題は(実は?)SGX 特有ではなく、何かのデータを暗号化する場合のかなり一般的な問題です.3 はキーの比較処理の過程で漏洩するからです.3 において順序関係が漏洩した場合、セキュリティ的な強度は順序保存暗号程度にまで落ちます.論文ではこのように素朴な実装はシンプルであるため実装が容易な一方で、性能上・セキュリティ上の問題点を生じさせると述べています.論文の構成的には、「なので、しっかりとトレードオフを考えることが大事だよ」という話です.

設計ポイント
上記の B+ tree の例から、なんとなく SGX 特有の課題に対処するための工夫が必要そうなことが分かりました.以降では論文の流れに沿って、いくつかの実装上の重要なポイントと選択肢を見ていきます.論文で述べられている実装上のポイントは以下の 5 つです.
- 暗号化の粒度
- enclave で実行するロジックの選定
- メモリアクセスの粒度
- enclave メモリの利用方法
- レコード ID の保護方法
暗号化の粒度
論文では Encryption Granularity と書かれている部分です.暗号化の粒度は上述した B+ tree の例のような item (e.g. インデックスのキー、カラム)レベルのものと、page レベルのものがあります.この page は Buffer Pool に格納されるヒープページのことを指しています.item レベルの暗号化は B+ tree の例のように既存の操作(B+ tree なら node の split など) への影響がないために実装が容易である点で優れています.一方で、保護対象のデータ構造の "構造" (頭痛が痛いみたいですが)は維持されてしまうため、その構造から分かる順序関係などの情報などは漏洩してしまいます.また、暗号化処理回数の増加による性能低下や ciphertext amplification , Ecall の頻発(ほとんど上述した B+ tree の例と同様)も発生します.
enclave で実行するロジックの選定
最小限のロジックだけを enclave で実行する(つまり TCB 最小化を主眼とする)場合、インデックスを走査するときのキーの比較処理のみを enclave 内で実行し、B+ tree と Buffer Pool の全てのデータ構造を enclave 内に配置できます.ただし、この設計では Ecall が頻発しますし、キーの順序関係の漏洩が生じます.逆に全てのデータ構造を enclave 内に配置した場合、Ecall はほとんど発生せず、かつ漏洩する情報も最小限になります.
メモリアクセスの粒度
これは少し表現がわかりづらいのですが、アクセスパターンの漏洩が焦点です.例えば、暗号化の粒度で item レベルの暗号化を選択した場合、レコードへのアクセスパターンが漏洩します.僕はあまり詳しくありませんが、このようなアクセスパターンの漏洩も攻撃に利用されうるため、対策が必要らしいです.逆に page レベルの暗号化を選択した場合、特定の 1 item にアクセスするだけでも page 全体を enclave にロードする必要がありますが、page 内のどのレコードにアクセスしたかのパターン情報は漏洩しません.
enclave メモリの利用方法
どのデータを enclave に常駐させるか?という話です.論文内では頻繁にアクセスされるデータを配置するといいのでは?みたいなことを言っています.無限の enclave があれば全て解決しますが、実際はそうはいかないという.
レコード ID の保護
ちょっとここは自分も理解できていないのですが、レコードの識別子である rid をどう保護すべきか?という話をしています.理解できたら追記します.
おわりに
だいぶ勢いで書きました.続きも書けたらいいなと思います.
2023 年の振り返り
はじめに
1 年の振り返りというやつです.スマブラと研究をしていました.
スマブラ
今年は何の年かと聞かれたらスマブラの年ですと答えるくらいにはスマブラをしていました.研究室になぜかスマブラが常備されているため、1日1~3時間くらいしてしまいました.うちの研究室はやることやっていれば何してもいいスタンスなので、スマブラをやるために研究をしていたと言っても過言ではないです.
僕は剣士キャラが好きで最初はアイクを使っていましたが、10月あたりからはマルスをメインに使っています.アイクは基本的には空Nをこするだけのキャラなのですが、(1) 復帰が辛い (2) 発生が遅い (3) ガード固めの相手は割とテク(透かしつかみなど)がいる、などの点が辛かったです.ただ、武器である剣のリーチの長さを活かすために間合い管理を意識できるようになったのが良かったです.マルスは先端を当てるのが気持ちよすぎて今ではほぼメインです.アイク以上に間合い管理が重要になるので、間合い管理の能力は伸びたと思います.また、アイクよりも復帰阻止が断然強いため、復帰阻止も上達しました.特にマベ1段でディレイかけてからの空後はそこそこの精度になった気がします.また、最近はあえて急降下せずに様子を見てから技を出す、みたいなことも少しできるようになりました.反射神経が良くないのでたびたび判定で負けるデメリットもありますが、なんかかっこいいので最近は技をあえてあまり出さずに様子を見るような立ち回りをしがちです.ただ、(1) 崖・地上受け身 (2) 台を使った確定コンボ(上強・空上でつなげるやつ)(3) 掴みの精度 (4) 相手に合わせた立ち回りなどは全く安定していないので、今後の課題です.特に (4) はオンラインをやっていないので身につかず、CPU 戦でなるべく色々なキャラに慣れるようにしています.ただ、最近はキンクルを使い始めてから「破壊は全てを解決する」と思い始めています.全人類はエクスタシーを見ましょう.メテオ楽しいです.
スマブラを始めてから動体視力は少し向上した気がします(?)
就活
僕は 2022 年の 10 月に入学しているのですが、12月あたりには内定を頂けました.結果としてスマブラ(研究)に集中できたので、非常に感謝しています.正確には去年の出来事ですが、去年の振り返りが存在しないのでここに含めておきます.
自分の就活はほとんど悩みませんでしたが、強いて言えばセキュリティとインフラどちらを軸にするかを悩みました.いや、就活当時はインフラ技術しか大して知らなかったので、むしろインフラを軸足にすると決めてから研究過程でセキュリティにも多少詳しくなったこの事態を自分の中でどう腹落ちさせるか、で悩んだのかもしれないです.観点としては主に 3 つで、
- 好きかどうか
- 得意かどうか
- 将来性があるかどうか
です.まず好きなのは間違いなくインフラです.セキュリティは研究をする上では楽しいですが、CTF やセキュリティの業務(レッド・ブルー共に)はあまり興味が出ませんでした.次に得意かどうかですが、これもどちらかというとインフラの方が得意かなと思っています.インフラはいろいろな技術(アプリケーション・ネットワーク・ストレージ)を横断的に理解し、適切に組み合わせる、みたいなことが必要なのかな(?)と思ってますが、セキュリティに関してはむしろ、特定の技術に対する深度が大事な気がします.まあこれは完全に偏見なので、なんとなくです.最後に将来性があるかどうかですが、これはややセキュリティに軍配が上がるかなと思っています.LLM を始めとする AI 技術の発展に加えて、クラウドにおけるフルマネージド化の流れを見ていると、「本当に何十人もの人間が常に気をつけてインフラを設計・改善をしないといけないほどアプリケーションの複雑化は止まらないのか?」みたいな疑問があり、どこかでインフラ技術の発展がほとんどのアプリケーションが必要とする非機能要件を今よりもはるかに容易に満たせる世界が来てしまうのでは?と思っています.一方で、セキュリティは常にシステムが存在する限り需要は増え続ける分野な気がしています.また、自動化も心理的にしづらい気もします.
上記のようなことを考えていたのですが、最終的にはインフラがカバーする非機能要件の中には当然セキュリティに関するものも含まれており、セキュリティもできるインフラエンジニア(内定した職種で言えば SRE)として頑張ればいいのでは、となっています.今後どうなるかは分かりませんが、頑張りたいところです.
研究
スマブラに飽きたら研究をしていました.卒業まで 9 ヶ月残して修論はだいたい書けたので、ひとまず問題はないです.業績は全くないので、残りの期間で論文をちゃんと通せたらいいなあと思っています.大して書くことはないですが、どうせ筆をとる機会も大して無いので、駄文を生成します.内容は「研究を通して身についた気がするもの」です.
最初の 3 つの力は論文の構成そのままになっていると思います.Abstract や Introduction では 1 と 2 、Related Work や Preliminaries から Evaluation までを通して 3 が必要になる印象があります(適当).
研究の初期段階では、指導教員から研究テーマについて「それって何の意味があるの?」とか「それって誰が嬉しいの?」などの質問を受けます.僕なんかは「なんか面白そう・実装が楽しそう」という理由だけで研究テーマを考えていたので、色々な角度からどうにか上手いこと "良い研究っぽく聞こえる" ストーリーを考えます.これが 1 の力に繋がったと思います.物は言いようですね.僕は技術そのものが好きで情報系に来たタイプですが、研究では技術によって実現できること・社会に与える影響を答える必要があり、意外と楽しかったので、この能力が仕事でもなんか役立つといいなあと思っています.また、この段階ではどうしても少し抽象的というか、一歩引いた視点が必要になるため、もともと抽象的に物事を考えるのが苦手な自分にとっては良い薬になった気もします.今でも抽象的に考えるのは苦手ですが.これは指導教員の受け売りですが、修士の研究なんてのは成功しなくても論文が書けるのだから、良く言えば信念を、悪く言えばワガママを突き通すのが大事なのかなと思います.
何となくアイデアが固まると具体的なユースケースを考えます.つまり、自分の研究が具体的にどこで役に立つのか、を考えます.これも全く考えていなかったので、"なんだか最初からそのユースケースに着目していたかのような" ものを捻り出します.これが 2 です.やはり物は言いようです.僕の同期にはユースケースがトラウマになるほど嫌いな人がいますが、気持ちは分かります.特に情報系は技術先行な研究もそれなりに多く、実際に自分の提案したものが使われる状況を考えるのはかなり大変でした.理想的にはユースケースから研究を考えるのが良い(つまり既に存在する課題を解決する)気もしますが、自分のアイデアからユースケースを見つける(つまり自分の持つ考えや視点からこれまでに着目されていなかった問題を見つける)ような進め方も良い気がします.少なくとも自分は後者でした.まあ全部適当です.知らんけど.
3 は論文を書いたりスライドを作成したりするときに色々と考えました.僕の研究は国内でも取り組んでいる人が少ない分野であり、かつ根幹となるアイデア自体が(シンプルだけど)あまり過去にない類のものだったため、「背景からどう前提知識・関連研究を説明し、自分の提案につなげるか」という部分にだいぶ悩みました.方法論としてはありきたりですが、自分が最も着目してほしい研究のポイント(視点)から書くのがよいのかも?と思っています.例えば、研究がこれまでに他の研究で着目していなかった指標に着目している場合、既存研究もその指標の観点から述べます.まだ論文は 2 回しか書いてないので、あくまで現時点で言語化するとですが.このあたりの能力は技術ブログを書くときにも重宝しそうですが、自分はかなりの面倒くさがりなので、この能力が活用される機会はあまり多くない気がします.技術記事はせっかく面白いことをやっているのに主となるメッセージが分かりにくい(あるいはそうしたメッセージを持たない)ことも多いので、もっと論文に近いメッセージ性のある記事が出てくると個人的には面白いなと思っています.そんなことするくらいなら論文読めという指摘はその通りです.
4 は研究室内の議論(= 後輩の研究をチクチクする)で培われたと思います.指導教員や博士の先輩のような優秀な人を見ていると、自分の意見だけでなく他人の意見に対して非常に(時には本人よりも)解像度高く分析し、的確なコメントを行なっていました.こうした能力は分野に限定されるものではないため、自分としては特に身につけたい能力の一つでした.今でも身についているとは口が避けても言えないですが、センス or 議論の繰り返しの中でしか身につかない能力であり、少しずつ向上していると最近は感じています.仕事では期間・お金などの理由により妥協点を探すことになると勝手に考えているのですが、大学院は「膨大な時間の中で特定の問題を突き詰められる」場所なので、このような時間効率を無視した議論により培われる類の能力は卒業するまでに磨きをかけておきたいです.
まだまだ未熟ではありますが、研究生活の中で身につけるべき能力をほんの少しは身につけられたと思います.大学院の利点は
- 上述のような技術に依存しない能力の獲得
- 特定の技術を好きなだけ深められる
の 2 点だと思っており、残りの研究生活は後者に力を入れたいと思っています.具体的には研究の中でストレージ技術に特に興味を持っているため、このあたりの知識をちゃんと増やしていきたいです.研究の中で RDBMS を実装しているので、一般的なRDBMS の構成は把握しているのですが、インデックスとかトランザクションとか並行処理周りはほとんど何も知らないので、このあたりをしっかりと頑張りたいです.また、就職は SRE 職として内定を頂いているため、そのあたりの知識も少しずつインプットしたいです.ちなみに僕は国内のストレージ関連の論文の中で NAIST 卒業生の油井誠さんが書いたこの論文 (注:クリック時にダウンロードされます) が最も好きです.
私生活
端的に言えば、カスでした.自炊はしない、段ボールは開けない、無駄なサブスクを契約する、ジムは契約したのに行かない、冷蔵庫は買わない、電子レンジも買わない、IH も買わない、等.自分はだいぶ適当な環境でも生きていける人間だと自覚しました.
来年の抱負
- ISUCON 2024 に出場する
- ストレージ技術に詳しくなる
- ジャーナル投稿・国際会議 1 本通過
おしまい!
自作プロトコルスタック(全体像の理解〜ARPリプライ)
最近自作プロトコルスタックを始めました。 とりあえずpingからのARPリクエストにARPリプライするまでを実装できたので、備忘録として残しておきます。 (コードはneddyというリポジトリで公開しています) ARP周りの実装を中心に解説するため、
については要所で簡単に触れるのみ、または全く触れないものとします。マスタリングTCP/IPなどを読んで、一通り全体像を理解した人がARPの実装をざっくりと理解できるような内容になっています。
全体像
いきなりARPの実装に入っても意味がわからないと思うので、まずは自作プロトコルスタックがどのような構成で動いているのか確認したいと思います。以下の画像を見てください。

まず、プロトコルスタックを自作する前に仮想デバイスを用意する必要があります。Linuxでは仮想Ethernetデバイスとして振る舞うTAPデバイスをユーザーが自由に作成できるので、これを使います。(図では分かりやすさのためにノードの中にプロトコルスタックがあるように見えますが、実際にそのような対応関係はありません)このような構成でプロトコルスタックを自作する利点として、
- 本来ring0で動作するプロトコルスタックを普通のユーザープログラムとして動かせる
- 上記の理由からgdbなどによるデバッグが簡単
- デバドラ実装をサボってTAPデバイスのread/writeでパケットの読み書きが可能
などが考えられると思います。以下のようなコマンドを打って、TAPデバイスをreadすればすぐに届いたパケットが見れるので、実装を始めるハードルはとても低いです。 (Ethernetデバイスドライバ = TAPデバイスに対する read/ writeみたいなイメージです)
$ sudo ip tuntap add mode tap user $USER name tap0
$ sudo ip addr add 10.0.0.1/24 dev tap0
$ sudo ip link set tap0 up
今回やること
pingからのARPリクエスト にARPリプライして、pingがICMPエコーリクエストを送信してくるのを確認するところまでを実装します。 事前に行うTAPデバイスの初期化処理などは省略し、主にARPに関連する部分を実装していきます。 pingによる疎通確認までの動作を以下のような4ステップに分解し、今回は3までを確認します。(ping側の視点で書いています)
今回の実装に特に関係するのは1,2のみです。1ではEthernetヘッダ、ARPヘッダのパースを行い必要な情報(送信元MACアドレスや送信元IPなど)を取り出します。2ではARPリプライパケットを作成します。(といっても、送信されてきたパケットを一部改変したパケットを返すだけなので、1の処理が今回のメインになります)3に関してはARPリプライが正常に送信されたことをチェックするために、tcpdumpで一応確認する程度に留めます。
実装
ここから具体的な実装を説明していきます。
※ TAPデバイスの初期化についてはneddyの tap.c に書いてあります。
ARPパケットの構造
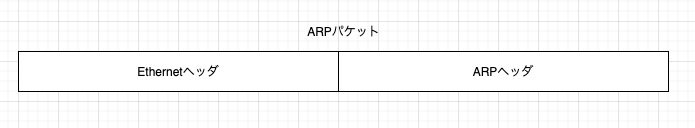
APRパケットはEthernetヘッダ + ARPヘッダという構造になっています。
Ethernetヘッダ→ARPヘッダの順番で見ていきたいと思います。
ざっくりと把握するだけならWikipedia を見ると良いです。
Ethernetヘッダの構造を理解する
Ethernetヘッダは14バイトで構成されており、
- 宛先アドレス(6バイト)
- 送信元アドレス(6バイト)
- タイプ(2バイト)
という内訳になっています。構造体にすると、以下のようになります。
#define ETHER_ADDR_LENGTH 0x06
#define IPV4_ADDR_LENGTH 0x04
struct ether_hdr {
    uint8_t dst_addr[ETHER_ADDR_LENGTH];
    uint8_t src_addr[ETHER_ADDR_LENGTH;
    uint16_t type;
} __attribute__((__packed__));
プロトコルスタックは受信したパケットの宛先アドレスを確認し、自分宛でなければその時点でパケットを破棄します。ARPパケットの場合はブロードキャストで送信されるため、宛先アドレスが f:fff:ff:ff:ff:ff になります。ブロードキャストの場合は何かしら対応が必要なので、タイプを確認した上でどうハンドリングするかを決定します。タイプには決められた複数の値が指定可能であり、値の一覧はIEEE 802 numbersで参照できます。ARPの場合は 0x0806 です。ARPパケットであればARPのハンドラにパケットを流す必要があります。neddyでは以下のような実装になっています。
if (conv_endian16(ethdr->type) == 0x0806) {
       struct arp_packet *arp = (struct arp_packet*)buff;
       dump_arp(arp);
       handle_arp(arp);
 }
conv_endian16 というのは、neddyで簡易的にビッグエンディアンをリトルエンディアンに変換する関数です。
TCP/IPではパケットのヘッダ部に関して、ビッグエンディアンを採用しています。一方で、普通のホストではリトルエンディアンでバイト列を取り出します。
そのため、変換用の関数が必要になります。(@drumato さんに教えていただきました。ありがとうございます。)
こんにちは.
— Drumato (@drumato) 2021年2月11日
私はKLab Expert Campで同じくプロトコルスタックを実装しているものです.
ネットワークバイトオーダの考慮をしていない,という可能性はないですか?
バイトオーダがホストのものと異なる場合があり,micropsではネットワークバイトオーダからホストへの変換が実装されているかと.
ARPパケットの構造体を定義する
ここまででEthernetヘッダを見て、パケットがARPパケットであることを確認しました。 次に、ARPパケットの中からARPヘッダを取り出し、ARPリプライパケットを作成する必要があります。 RFC826 を確認すればARPヘッダの具体的な構造は分かるので、ここでは仕様を構造体レベルに落とし込んで説明します。
struct arp_packet {
    struct ether_hdr ethdr;
    uint16_t hard;
    uint16_t pro;
    uint8_t hard_len;
    uint8_t pro_len;
    uint16_t opcode;
    uint8_t sha[ETHER_ADDR_LENGTH];
    uint8_t spa[IPV4_ADDR_LENGTH];
    uint8_t tha[ETHER_ADDR_LENGTH];
    uint8_t tpa[IPV4_ADDR_LENGTH];
} __attribute__((__packed__));
ARPヘッダは以下の9つのフィールドで構成されます。
- ハードウェアタイプ(2バイト)
- プロトコルタイプ(2バイト)
- ハードウェア長(1バイト)
- プロトコル長(1バイト)
- オペコード(2バイト)
- 送信元ハードウェアアドレス(6バイト)
- 送信元プロトコルアドレス(4バイト)
- 宛先ハードウェアアドレス(6バイト)
- 宛先プロトコルアドレス(4バイト)
ハードウェアタイプはRFCによると、現時点でハードウェアタイプはEthernetを示す 0x001 だけのようです。
Currently the only defined value is for the 10Mbit Ethernet (ares_hrd$Ethernet = 1).
プロトコルタイプはIPv4の場合は 0x0800 になります。
ハードウェアタイプがEthernet, プロトコルタイプがIPv4の場合はハードウェア長、プロトコル長がそれぞれ 0x06, 0x04 になります。
opcodeは、ARPリクエストの場合は 0x001 になり、ARPリプライの場合は 0x002 になります。ARPリクエストはブロードキャストで送信されるため、ARPリクエストパケットの宛先ハードウェアアドレスは無視します。
パケットを受信する
構造体が定義できたので、あとはパケットを受信する処理を書けば実際にpingから送信されたパケットを確認できるはずです。 上述の通り、TAPデバイスに送られてきたパケットは通常のファイルのread / write の要領でアクセス可能です。ざっくりとですが、以下のようなコードを書けばパケットが受信できます。やっていることはtapデバイスのファイルをreadしてtypeがARPであればそれをダンプしているだけです。 (MAX_PACKET_SIZEは今のところ適当な値を設定しています)
int rsize = 0;

for (;;) {
        rsize = read_packet(buff, MAX_PACKET_SIZE);

        struct ether_hdr *ethdr = (struct ether_hdr*)buff;

        dump_ether(ethdr);

        if (conv_endian16(ethdr->type) == 0x0806) {
            struct arp_packet *arp = (struct arp_packet*)buff;
            dump_arp(arp);
            handle_arp(arp);
        }
実際にpingから受信したARPパケットをダンプすると以下のような出力が得られました。
[Ethernet header]
dst addr=ff:ff:ff:ff:ff:ff
src addr=b2:6d:da:9:59:53
type=0x806(=ARP)
[ARP header]
hard_type=0x001, length 6
pro_type=0x800, length 4
opcode=0x001(=Request)
sha=b2:6d:da:9:59:53
spa=10.0.0.1
tha=0:0:0:0:0:0
tpa=10.0.0.2
spaが 10.0.0.1 になっているのは、pingから送信されたパケットが仮想EthernetデバイスであるTAPデバイス(10.0.0.1)からノード(10.0.0.2)へ転送されているためです。
僕はここら辺を理解するのに結構悩んだのですが、Twitterで @pandax381 さんに色々教えていただきました。ありがとうございます。
やっと理解できました・・!!本当にありがとうございます🙇🙇
— メールちゃんと確認する (おしぼり) (@oshibori_vmm) 2021年2月15日
pingで10.0.0.2に届くARPパケットの送信元が10.0.0.1なのは、仮想Ethernetデバイスとして振る舞うtapデバイスから10.0.0.2のノードへパケットが転送されているからという認識で合っているのでしょうか?(何度もすみません)
はい、その通りです👌 tapデバイスをオープンしているプロセスがARPリプライを返せばOSのプロトコルスタック側からtapの先にノードが存在するように見え、なにも返さなければ存在しないように見えます。
— YAMAMOTO Masaya (@pandax381) 2021年2月15日
なお、ARPのリプライやEthernetヘッダのMACアドレスは任意の値でも動作します。
ARPリプライパケットの作成と送信
ARPパケットを受信して中身を確認することができたので、次はARPリプライを送信する必要があります。 pingの送信元に対してARPリプライを送信すると、pingはICMPエコーリクエストを返してくれるはずです。 ARPリプライの作成についてRFCでは以下のように書かれています。
Swap hardware and protocol fields, putting the local hardware and protocol addresses in the sender fields. Set the ar$op field to ares_op$REPLY Send the packet to the (new) target hardware address on the same hardware on which the request was received.
書かれている内容を具体的な実装に落とし込むと、以下の通りの変更を加えれば良さそうです。
- 宛先ハードウェアアドレスをARPリクエストパケットのshaにする
- 宛先プロトコルアドレスをリクエストのspaにする
- 送信元ハードウェアアドレスノードのハードウェアアドレスにする
- 送信元プロトコルアドレスをノードのIPアドレスにする
- opcodeを
0x02(= Reply) にする
ARPリプライパケットを作成し送信するコードは以下の通りです。 (現時点での実装はヒジョーーーーに雑なので、リトルエンディアンからビッグエンディアンへの変換関数の実装をサボってビッグエンディアンでベタ書きしています・・・)
int arp_reply(struct arp_packet *request) {
    struct arp_packet arp;
    int wsize;

    arp.hard = 0x100;
    arp.pro = 0x008;
    arp.hard_len = ETHER_ADDR_LENGTH;
    arp.pro_len = IPV4_ADDR_LENGTH;
    arp.opcode = 0x0200;
    memcpy(arp.sha, get_tap_hwaddr(), 6);
    memcpy(arp.spa, get_tap_ipaddr(), 4);

    // setup ethernet header
    memcpy(&arp.ethdr.dst_addr, request->sha, ETHER_ADDR_LENGTH);
    memcpy(&arp.ethdr.src_addr, arp.sha, ETHER_ADDR_LENGTH);
    arp.ethdr.type = 0x0608;

    memcpy(&arp.tha, request->sha, ETHER_ADDR_LENGTH);
    memcpy(&arp.tpa, request->spa, IPV4_ADDR_LENGTH);

    dump_ether(&(arp.ethdr));
    dump_arp(&arp);

    if ((wsize = write_packet(&arp, sizeof(arp))) < 0) {
        return -1;
    }

    printf("write %d bytes\n", wsize);

    return 1;
}
この時、送信元ハードウェアアドレスをどうするかちょっと悩みました。これについても @pandax381 さんに教えていただき、00:00:5e:00:53:01 というアドレスを使用することにしました。ドキュメント用アドレスについては ここ が参考になりました。
自作プロトコルスタックの使うHWアドレスについては、動作するかという視点であれば任意の値でで大丈夫です。勝手に他者のOUIを使うのはお行儀が良くないので、テストの範囲であればドキュメント用のOUIを使うのがいいと思います(僕はそうしています)。
— YAMAMOTO Masaya (@pandax381) 2021年2月19日
変更後のARPパケットをダンプすると以下のような出力が得られます。
[Ethernet header]
dst addr=b2:6d:da:9:59:53
src addr=00:00:5e:00:53:01
type=0x806(=ARP)
[ARP header]
hard_type=0x001, length 6
pro_type=0x800,  length 4
opcode=0x002(=Reply)
sha=00:00:5e:00:53:01
spa=10.0.0.2
tha=b2:6d:da:9:59:53
tpa=10.0.0.1
ICMPエコーリクエストの確認
ARPリプライが正常に送信されていれば、10.0.0.2宛にpingからICMPエコーリクエストが届くはずです。 今回はtcpdumpを利用して、1特定のTAPデバイスに絞ってパケットを見ることにしました。
tcpdump -i <tap_name>
<tap_name> は作成したTAPデバイスによります。例えば、tap0という名前でTAPデバイスを作成したのならtap0になります。
上記のコマンドを入力した上で、自作プロトコルスタックとpingを動かすと以下のような出力が得られます。 ARPリプライが送信され、pingからICMPエコーリクエストが送信されていることが確認できます。
20:23:32.295711 ARP, Request who-has 10.0.0.2 tell <----my_usrename---->, length 28
20:23:32.295870 ARP, Reply 10.0.0.2 is-at 00:00:5e:00:53:01 (oui IANA), length 28
20:23:32.295886 IP <----my_usrename----> > 10.0.0.2: ICMP echo request, id 5196, seq 1, length 64
20:23:33.325972 IP <----my_usrename----> > 10.0.0.2: ICMP echo request, id 5196, seq 2, length 64
20:23:34.350099 IP <----my_usrename----> > 10.0.0.2: ICMP echo request, id 5196, seq 3, length 64
未対応の仕様について
ここまでで、ARPリプライが正しく送信されていることが確認できました。最後にneddyで未対応の実装について軽く触れて終わりにしたいと思います。 現在のneddyではアドレス変換テーブルの更新やエントリの追加に関して、RFCの仕様に準拠していません。RFCによると、ARPリクエストの受信側ではopcodeの確認より前にパケットのプロトコルタイプとプロトコルアドレスのペアをチェックします。もしそのペアに該当するエントリがアドレス変換テーブルに存在すればハードウェアアドレスを更新します。この動作について、 RFC826では以下のように書かれています。
If the pair
is already in my translation table, update the sender hardware address field of the entry with the new information in the packet and set Merge_flag to true.
もしそのペアが存在しない場合はアドレス変換テーブルに新しいエントリとして登録します。
If Merge_flag is false, add the triplet
to the translation table.
現状のneddyではまだアドレス変換テーブル自体が存在しないのでこれについては未対応です。
まとめ
早くTCP/IPレイヤの実装に取り掛かれるように頑張ります。 この記事を読んでいればわかると思いますが、Twitter上で本当にたくさんの人にアドバイスを頂きました。 本当にいつもありがとうございます!! この記事に書かれている内容に関して、間違いや問題点などがあればドシドシ指摘してもらえると嬉しいです。
